找回密码
 立即注册
搜索
楼主: 绕指流光

[科技] OPENAI数学氢弹雨来袭 | 大模型讨论专楼

 火... [复制链接]
     
发表于 2026-8-27 10:55 来自手机 | 显示全部楼层
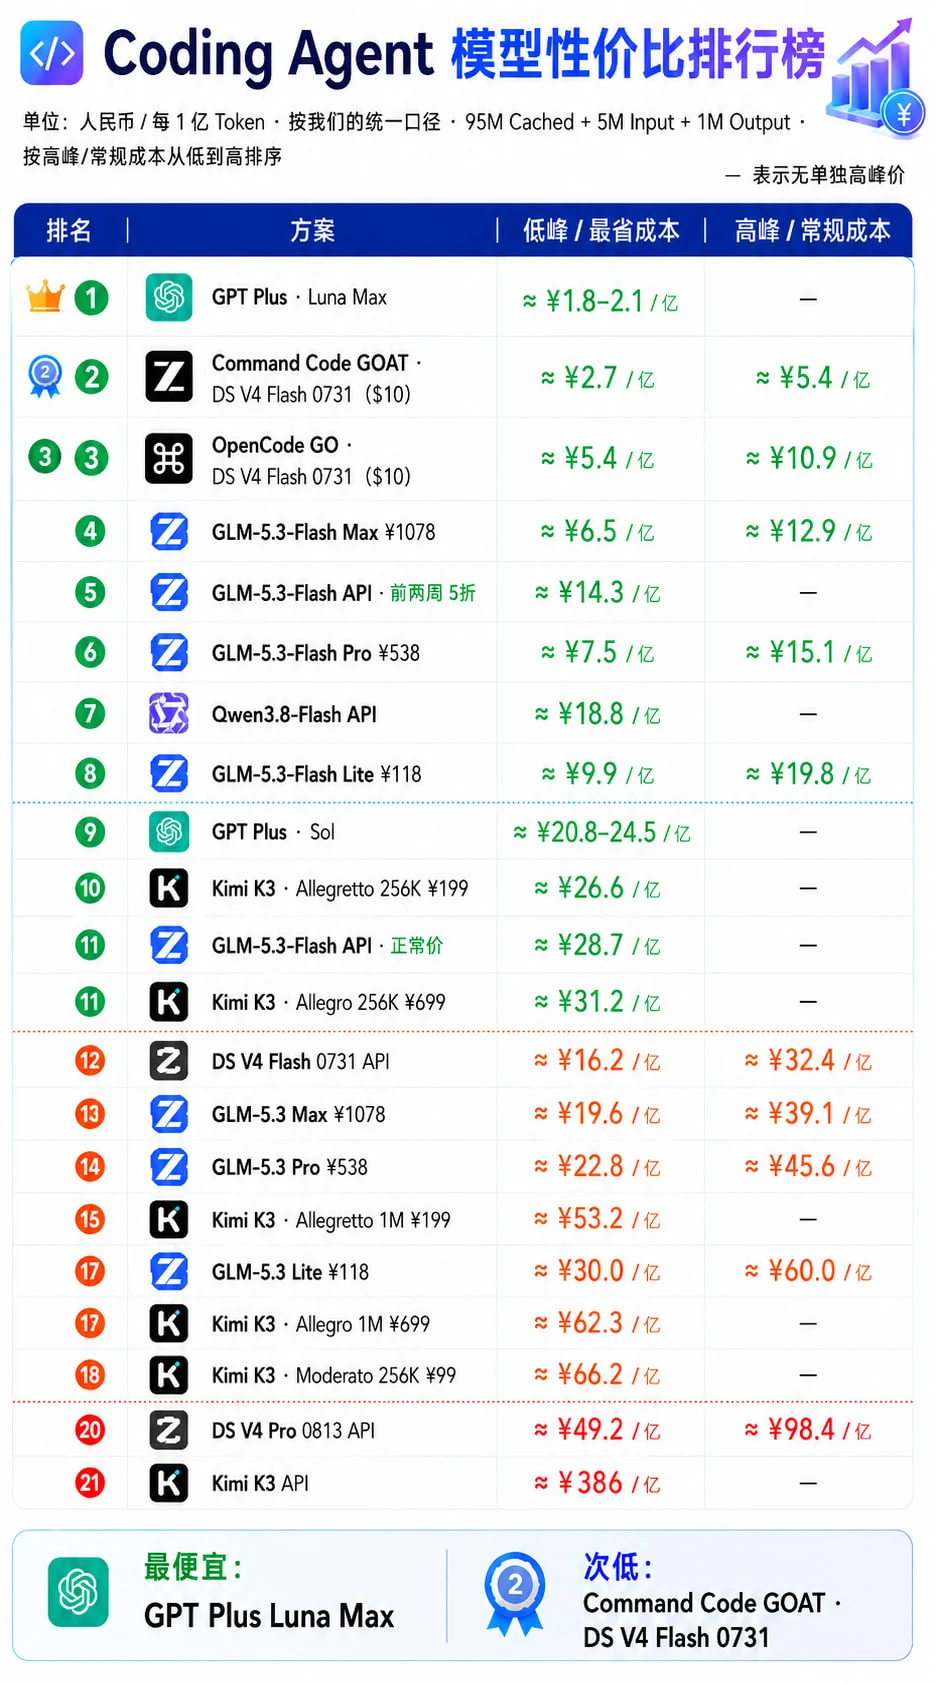
还真是比套餐便宜
回复

使用道具 举报

     
发表于 2026-8-27 10:57 来自手机 | 显示全部楼层
Azcarlo 发表于 2026-8-27 10:53
等一个glm 5.3 flash 用量实测,有人说折价的api 比套餐便宜,我感觉不大可能。

— from Xiaomi 23127PN0C ...

用量 看看11471楼
按量计费比套餐便宜是因为定价的问题,套餐里定的很贵

—— 来自 Xiaomi 25060RK16C, Android 16, 鹅球 v3.5.99
回复

使用道具 举报

     
发表于 2026-8-27 10:59 来自手机 | 显示全部楼层
本帖最后由 Azcarlo 于 2026-8-27 11:04 编辑

这图里的不是比套餐贵吗
这图有问题吧,智谱的套餐还有峰谷价
woc还真有,api比高峰的套餐便宜
— from Xiaomi 23127PN0CC, Android 16, S1 Next Goose v3.5.99
回复

使用道具 举报

     
发表于 2026-8-27 11:01 来自手机 | 显示全部楼层
nvidia nim的手机收不到验证码的 有人有办法解决吗

—— 来自 vivo V2561A, Android 16, 鹅球 v4.0
回复

使用道具 举报

     
发表于 2026-8-27 11:02 | 显示全部楼层
回复

使用道具 举报

     
发表于 2026-8-27 11:04 | 显示全部楼层
我早上让glm5.3flash给我蹬了一个html游戏,模拟经营的。。。我给了它参考游戏,我以前用dsf和hy3做的。
结果glm它做了2小时了,第一波花费了我1500积分。。。因为它觉得花的太多了自动给我停了,还问我要不要继续。
第二波还在蹬。。。还有3步。。不知道还要多久和多少积分
感觉比dsf慢很多,。感觉它一直在改各种bug
还在继续等结果
回复

使用道具 举报

     
发表于 2026-8-27 11:06 | 显示全部楼层
还有不知道是不是错觉,5.3Flash比牛来时的智力水平降低了……
回复

使用道具 举报

发表于 2026-8-27 11:06 | 显示全部楼层
nxmonitor 发表于 2026-8-27 10:49
雷霆大思考问题比较严重,engram好像会让这个模型的规划能力提升,会学着大参数模型的做法去做,问题是智 ...

感觉deepseek的神秘灰测模型应该就是加上了这个engram,看他思考的时候非常自信,能很好的规划任务
回复

使用道具 举报

     
发表于 2026-8-27 11:07 | 显示全部楼层
commandcode的v4f难道是他们自己部署的?怎么感觉有点降智
回复

使用道具 举报

     
发表于 2026-8-27 11:07 | 显示全部楼层
据多家外媒报道,知名开源模型网站Hugging Face被英伟达129亿美元收购
回复

使用道具 举报

     
发表于 2026-8-27 11:09 | 显示全部楼层
wandeeees 发表于 2026-8-27 11:06
感觉deepseek的神秘灰测模型应该就是加上了这个engram,看他思考的时候非常自信,能很好的规划任务 ...

出了以后就知道了,我觉得可能大模型用上engram更强,一两百B的模型用着可能是因为智力不够的问题,老是在改里面的东西,导致思维链超长,运行时间也离谱
回复

使用道具 举报

     
发表于 2026-8-27 11:13 | 显示全部楼层
V4FV其实已经卡在过度思考的边缘了,新出的这两个的完成任务的时长绝对是不能忍的
回复

使用道具 举报

     
发表于 2026-8-27 11:24 | 显示全部楼层
给了GLM-5.3-Flash一个285MB的工具,minimaxM3写的,改了一个小bug,一轮改完,但是改完后一直在自检,卡了几分钟没动,我手动停止了,加了2个小功能,第一轮改完又在自检卡住,我手动停止,测试了一下,因为描述不到位只做好了一个功能,第二个功能做了一半,完善描述后一轮做好。但是一直在做最后检查和收尾。感觉检查和收尾比改bug做功能还慢。一共用了7天体验卡的165积分,还行。但是有个大问题,我接入的hermes,两次强调【你是多模态模型 可以自己看图片】,但是他还是认为【截图我暂时看不了】。
回复

使用道具 举报

     
发表于 2026-8-27 11:25 | 显示全部楼层
目前我的订阅结构:gpt plus。网页版review github代码,规划;
luna跑在hermes层做agent接口(但是luna对话体验不如DeepSeek,目前开发阶段主要看中他指令遵从和安全意识比较高),缺点是慢。
DeepSeek、ox这类模型做子代理,之前用minimax m3,但发现minimax任务完成率太低了,总需要主agent返工。
另外谷善人的agy cli当一个系统外高级子代理。
minimax plus年付(一直想退,但是又觉得150%周限退了可惜),主要拿来跑记忆提炼、以及网页压缩、上下文压缩、视觉等hermes里的8个辅助模型,以及一些需要消耗大量token的实验性任务。但minimax连稳定的输出结构都不能保持。
后续考虑:opencode go套餐里的低价模型比如小米、musk啥的接替minimax的位置。月度成本已经140+80+70了。opencode其实跟minimax年付重复了,而且是不是能体验点其他更聪明的模型。希望minimax能下半年发发力起码蒸馏出来个flashTT
回复

使用道具 举报

     
发表于 2026-8-27 11:33 | 显示全部楼层
蹬完了,,做的还是意外的不错。看起来像模像样,总感觉这个ai肯定吃了很多小红薯的资料
准备扔给我的玩家测试了……

本帖子中包含更多资源

您需要 登录 才可以下载或查看,没有账号?立即注册

×
回复

使用道具 举报

     
发表于 2026-8-27 11:39 | 显示全部楼层
LeoDT 发表于 2026-8-27 09:34
写代码的话,现在有一波“什么记忆系统都不靠谱,代码才是唯一事实”的小趋势。

我实际体验下来也是,优 ...

写代码的话肯定要自己管理上下文吧,什么自动记忆系统都是干扰
真正有价值需要持久化的东西就要记成文档,什么该记什么不该记这个问题业界都还在争论,怎么可能指望ai帮你自动记
回复

使用道具 举报

     
发表于 2026-8-27 11:40 | 显示全部楼层
goranger 发表于 2026-8-27 11:25
目前我的订阅结构:gpt plus。网页版review github代码,规划;
luna跑在hermes层做agent接口(但是luna对 ...

我开了minimax的MAX月付 不过蹬了1.15B token后觉的理科工作还是不太适合他  但是文科方面的工作完成的很好  下个月我会改成plus
我不需要重度编程  v4完全能满足我理科方面的工作了 所以昨天开了commandcode爽蹬 opencodego套餐5美元开了一个月  月用量82.1%了  还剩14 天 1 小时到期不续了  
其他火山 api易 阿里云 deepseek都有几元余额没用完 留着备用吧
回复

使用道具 举报

     
发表于 2026-8-27 11:46 来自手机 | 显示全部楼层
几个都看了下,工作日还是太贵了,一天一顿饭钱还是太痛了,索性还是本地27b跑跑吧,晚上再蹬
回复

使用道具 举报

     
发表于 2026-8-27 11:48 来自手机 | 显示全部楼层
老黄上了0813,现在没多少人发现速度还很快
回复

使用道具 举报

     
发表于 2026-8-27 11:52 | 显示全部楼层
唠叨 发表于 2026-8-27 11:40
我开了minimax的MAX月付 不过蹬了1.15B token后觉的理科工作还是不太适合他  但是文科方面的工作完成的很 ...

我咋看linux do上说cg又是路由好几个供应商导致掉缓存又是说要涨价的。
回复

使用道具 举报

     
发表于 2026-8-27 11:57 | 显示全部楼层
d4v挺好用的,现在这些sol ultra又慢又贵的模型到底谁在用啊 不知道怎么弄的
回复

使用道具 举报

     
发表于 2026-8-27 12:01 | 显示全部楼层
本帖最后由 唠叨 于 2026-8-27 12:02 编辑
goranger 发表于 2026-8-27 11:52
我咋看linux do上说cg又是路由好几个供应商导致掉缓存又是说要涨价的。


除了速度比官网慢一半外没察觉到什么问题,智力也正常,

官网我也一直在蹬,除了速度没有明显区别。

本帖子中包含更多资源

您需要 登录 才可以下载或查看,没有账号?立即注册

×
回复

使用道具 举报

     
发表于 2026-8-27 12:36 | 显示全部楼层
https://stock.10jqka.com.cn/20260827/c679342056.shtml

阿里云公告,大模型服务平台百炼将于北京时间2026年8月27日12:00:00起,对Qwen3.8-Flash模型模式计费单价进行下调调整。Qwen3.8-Flash是千问最新推出的多模态大模型,原生支持百万级上下文窗口,可一次性处理超长文档、代码仓库与复杂对话,在编程辅助、智能体协作、图文理解等场景中表现突出,兼容OpenAI与Anthropic接口协议,适合构建高并发应用与智能工作流。具体如下:输入价格调整前1元,调整后0.8元;输出价格调整前3元,调整后2.7元。
回复

使用道具 举报

     
发表于 2026-8-27 12:37 来自手机 | 显示全部楼层
tonyunreal 发表于 2026-8-27 12:36
https://stock.10jqka.com.cn/20260827/c679342056.shtml

阿里云公告,大模型服务平台百炼将于北京时间202 ...

不调缓存价格感觉还是亏
回复

使用道具 举报

     
发表于 2026-8-27 12:40 | 显示全部楼层
tonyunreal 发表于 2026-8-27 12:36
https://stock.10jqka.com.cn/20260827/c679342056.shtml

阿里云公告,大模型服务平台百炼将于北京时间202 ...

缓存一毛,打平梁文峰, 到梁文谷就不行了
回复

使用道具 举报

     
发表于 2026-8-27 12:41 | 显示全部楼层
为什么都对缓存命中的价格语焉不详?这么不坦率
回复

使用道具 举报

     
发表于 2026-8-27 12:49 来自手机 | 显示全部楼层
牢梁缓存价格这么低,推理毛利还能做到80%以上

—— 来自 HONOR AAK-AN00, Android 16, 鹅球 v3.5.99
回复

使用道具 举报

     
发表于 2026-8-27 12:54 | 显示全部楼层
原来gpt不说人话不是免费网页版的问题吗

论坛助手,iPhone
回复

使用道具 举报

     
发表于 2026-8-27 12:55 来自手机 | 显示全部楼层
CCauchy 发表于 2026-8-27 12:54
原来gpt不说人话不是免费网页版的问题吗

论坛助手,iPhone

这模型就这样,电报体加不说人话,跟名片似的

—— 来自 HUAWEI SGU-AL10, Android 16, 鹅球 v4.0
回复

使用道具 举报

     
发表于 2026-8-27 12:56 | 显示全部楼层
lactone 发表于 2026-8-27 12:49
牢梁缓存价格这么低,推理毛利还能做到80%以上

—— 来自 HONOR AAK-AN00, Android 16, 鹅球 v3.5.99 ...

SSD缓存是梁叔叔的独家秘籍
回复

使用道具 举报

     
发表于 2026-8-27 12:58 来自手机 | 显示全部楼层
med 发表于 2026-8-27 11:57
d4v挺好用的,现在这些sol ultra又慢又贵的模型到底谁在用啊  不知道怎么弄的 ...

通过日志查bug这个场景最适合,而且还要思考开高,开个窗口和worktree扔一边让它慢慢玩就行

回复

使用道具 举报

     
发表于 2026-8-27 13:01 | 显示全部楼层
半江瑟瑟半江红 发表于 2026-8-27 12:55
这模型就这样,电报体加不说人话,跟名片似的

—— 来自 HUAWEI SGU-AL10, Android 16, 鹅球 v4.0 ...

a畜的感觉也不是很说人话,目前还是哈吉米3.1读起来最舒服,就是有的时候有点舔狗,ds就中规中矩

论坛助手,iPhone
回复

使用道具 举报

     
发表于 2026-8-27 13:03 来自手机 | 显示全部楼层
CCauchy 发表于 2026-8-27 13:01
a畜的感觉也不是很说人话,目前还是哈吉米3.1读起来最舒服,就是有的时候有点舔狗,ds就中规中矩

论坛助 ...

Gemini太舔了,有点恶心。d指导这方面我觉得最好

—— 来自 HUAWEI SGU-AL10, Android 16, 鹅球 v4.0
回复

使用道具 举报

发表于 2026-8-27 13:04 来自手机 | 显示全部楼层
因为现在的智能体缓存命中率都能到 98% 以上,所以一个大模型的缓存命中价格直接决定了这个模型的使用费用。所以你看到谁家的模型吹自己输入输出有多便宜,却闭口不提缓存命中价格的时候,你只要呵呵就可以了
回复

使用道具 举报

     
发表于 2026-8-27 13:05 来自手机 | 显示全部楼层
我觉得kimi是立场最坚定的,主打一个任何讨论都给你nuance

—— 来自 HONOR AAK-AN00, Android 16, 鹅球 v3.5.99
回复

使用道具 举报

     
发表于 2026-8-27 13:08 | 显示全部楼层
tillnight 发表于 2026-8-27 10:45
别洗了,谷歌研究员直接引用猜牛来的推,然后说如果说这是咕咕嘎嘎会怎么样?然后多名谷歌研究员用各种暧 ...

之前只看了一点截图,怎么能这么蹭的
回复

使用道具 举报

     
发表于 2026-8-27 13:14 | 显示全部楼层
0813用we need思维链还是很强的
回复

使用道具 举报

     
发表于 2026-8-27 13:19 | 显示全部楼层
好贵啊啊啊啊,glm5.3flash给我修一些bug就可以修几百上千积分。。。根本不能爽登。
还是我本地的qwen3.8 27b好,踏踏实实的干活,质量也能保持 还不花钱
唉。。。ds的0.4折时代啥时候回来
回复

使用道具 举报

     
发表于 2026-8-27 13:24 | 显示全部楼层
我试了下,把日常翻译的ds4flash换成了qwen3.8flash也还行,之前阿里那边qwenmt都比ds4flash贵
回复

使用道具 举报

     
发表于 2026-8-27 13:31 来自手机 | 显示全部楼层
唠叨 发表于 2026-8-27 11:24
给了GLM-5.3-Flash一个285MB的工具,minimaxM3写的,改了一个小bug,一轮改完,但是改完后一直在自检,卡了 ...

看不了那个是Hermes识图和主模型设置的问题,一开始v4fv也碰到过
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

Archiver|手机版|小黑屋|上海互联网违法和不良信息举报中心|网上有害信息举报专区|962110 反电信诈骗|举报电话 021-62035905|Stage1st ( 沪ICP备13020230号-1|沪公网安备 31010702007642号 )

GMT+8, 2026-10-13 06:00 , Processed in 0.113664 second(s), 7 queries , Gzip On, Redis On.

Powered by Discuz! X3.5 Licensed

© 2001-2026 Discuz! Team.

快速回复 返回顶部 返回列表