找回密码
 立即注册
搜索
查看: 1303634|回复: 14512

[科技] DeepSeek V4.1 Flash:更强、更快、更普惠 | 大模型讨论专楼

 火... [复制链接]
     
发表于 2026-3-1 16:42 来自手机 | 显示全部楼层 |阅读模式
本帖最后由 绕指流光 于 2026-9-10 21:22 编辑

本帖已不再局限 DeepSeek 相关,大模型新闻和应用心得等均可自由分享讨论,主楼用于不定时更新模型上线新闻
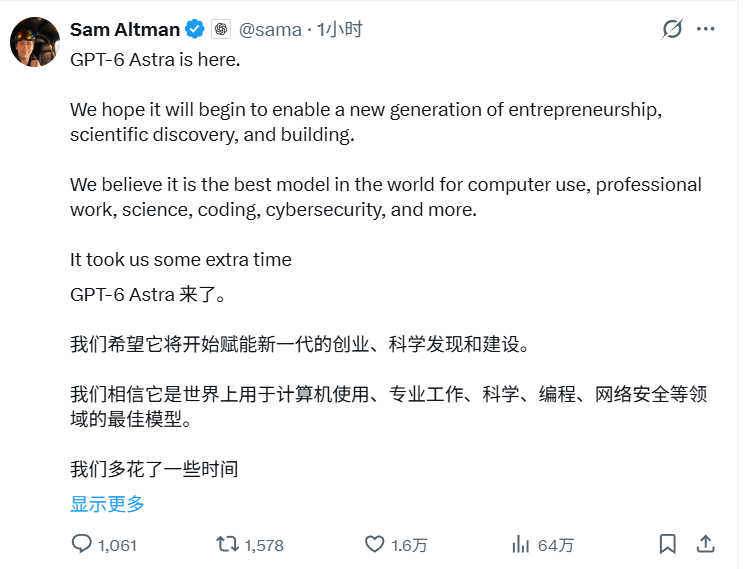
最近各种小版本大爆炸,主流玩家里还剩一个GPT Astra没有上新
0910
躺平躲爬期间爆炸消息太多,捡着最近的发了
DeepSeek V4.1 Flash:更强、更快、更普惠


0904
astra 已发布,爆炸炸炸炸,眩晕晕晕晕


0903
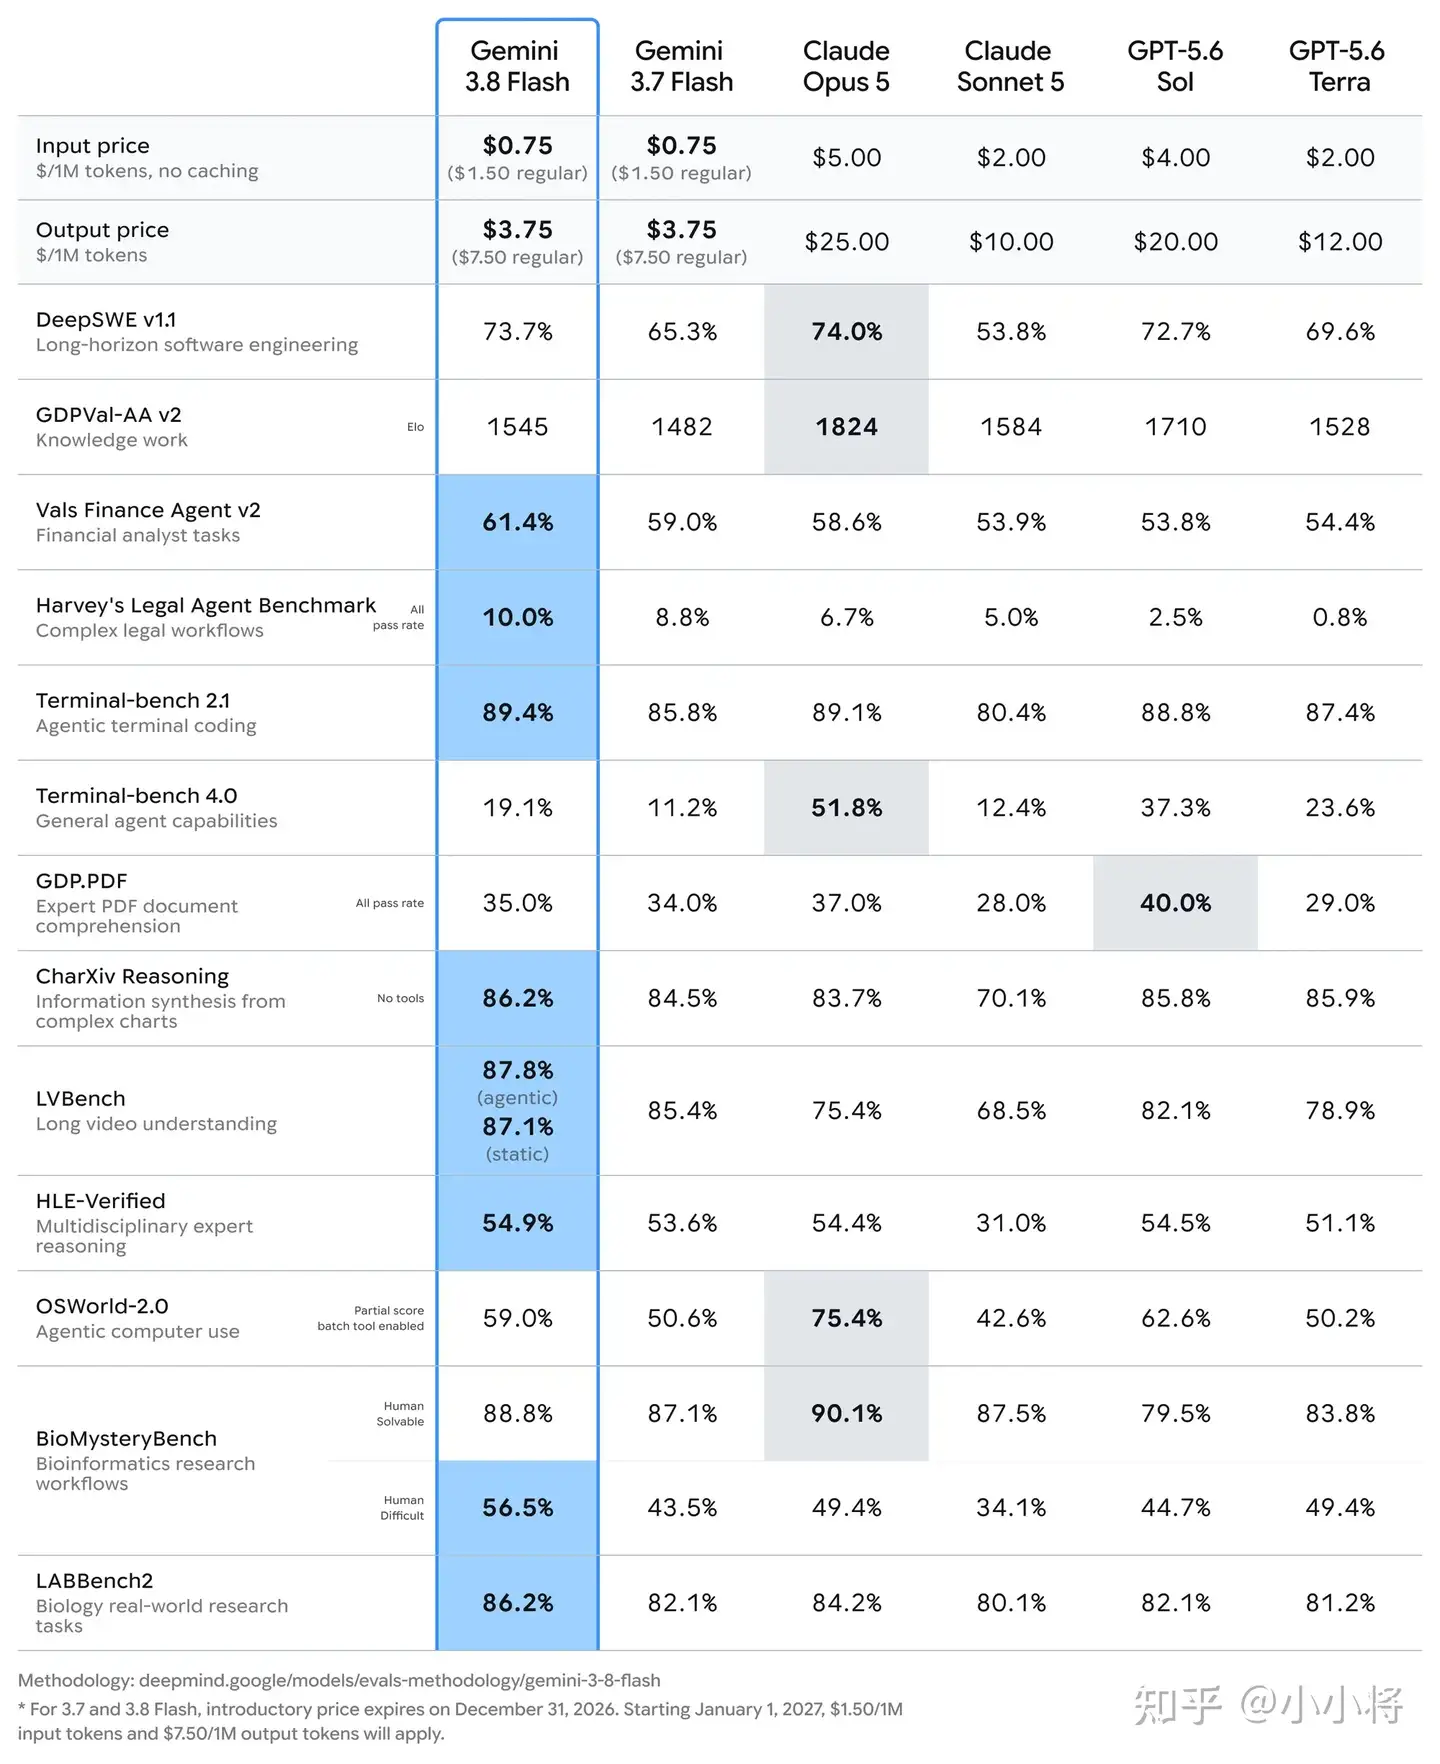
gemini 3.8 flash发布。体感哈基米还是哈基米


0902
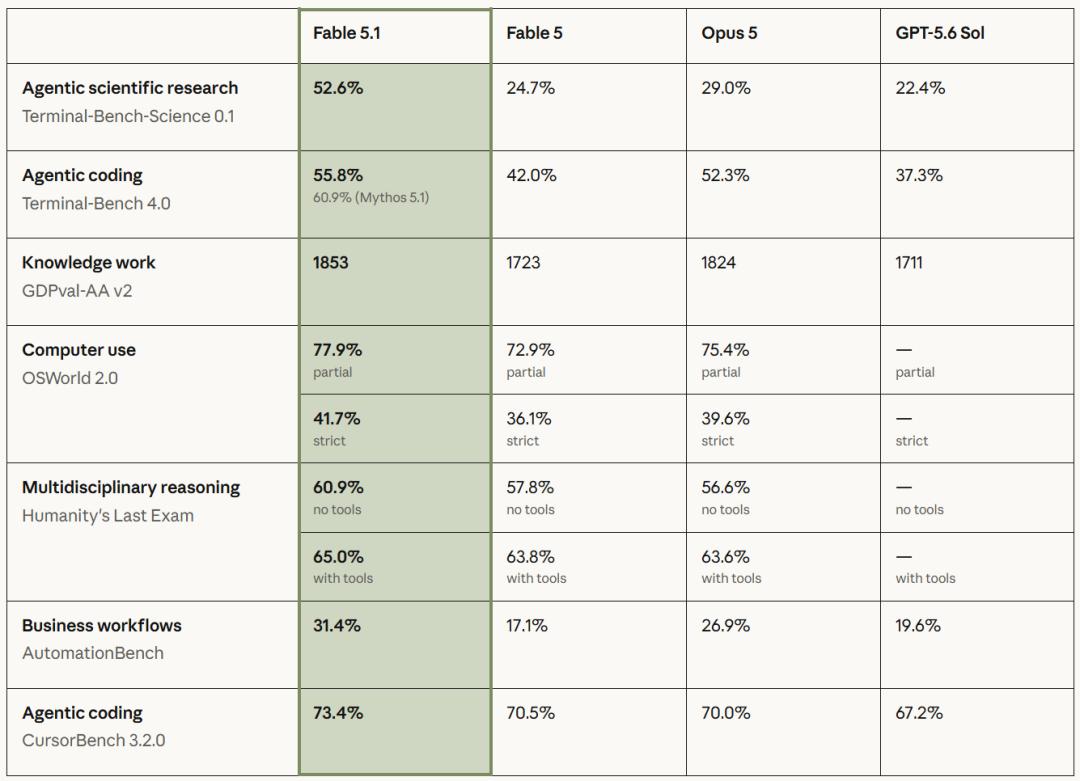
Claude Fable 5.1、Mythos 5.1发布,后者被锁在白名单内,专供受审核的网安与生命科学团队调遣。
A/自己的榜捧的可以说很高了


0827
牛来大模型(OX ALPHA)已被智谱认领为GLM-5.3-Flash
GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型,以极致低成本架构实现超越 GLM-5.2 的更强智能:
  • 极致高效的混合架构GLM-5.3-Flash 总参数量 320B、激活参数量 18B,是首个采用稀疏注意力与线性注意力混合架构的开源前沿模型。在保持精准长上下文能力的同时,显著降低计算与服务成本。相比 GLM-5.3,其注意力计算量和 KV 缓存大小分别降低 3.01 倍和 4.44 倍。
  • 原生多模态的视觉 Coding视觉能力被原生融入 Coding 循环,使模型能够主动观察界面、渲染结果与交互反馈,并据此持续测试和改进。无论是前端开发、游戏构建、Blender 3D 场景,还是 BUA、CUA 驱动的真实环境操作,模型都能在代码、浏览器和图形界面之间协同完成任务。
  • 超越 Coding 的专业工作伙伴GLM-5.3-Flash 进一步拓展至 Office、金融研究和专业文档等工作场景。它能够自主拆解复杂目标、调用合适工具、检查并优化输出,完成从研究分析、模型构建到 PPTX、PDF、DOCX、XLSX 成品交付的完整工作流。


0821
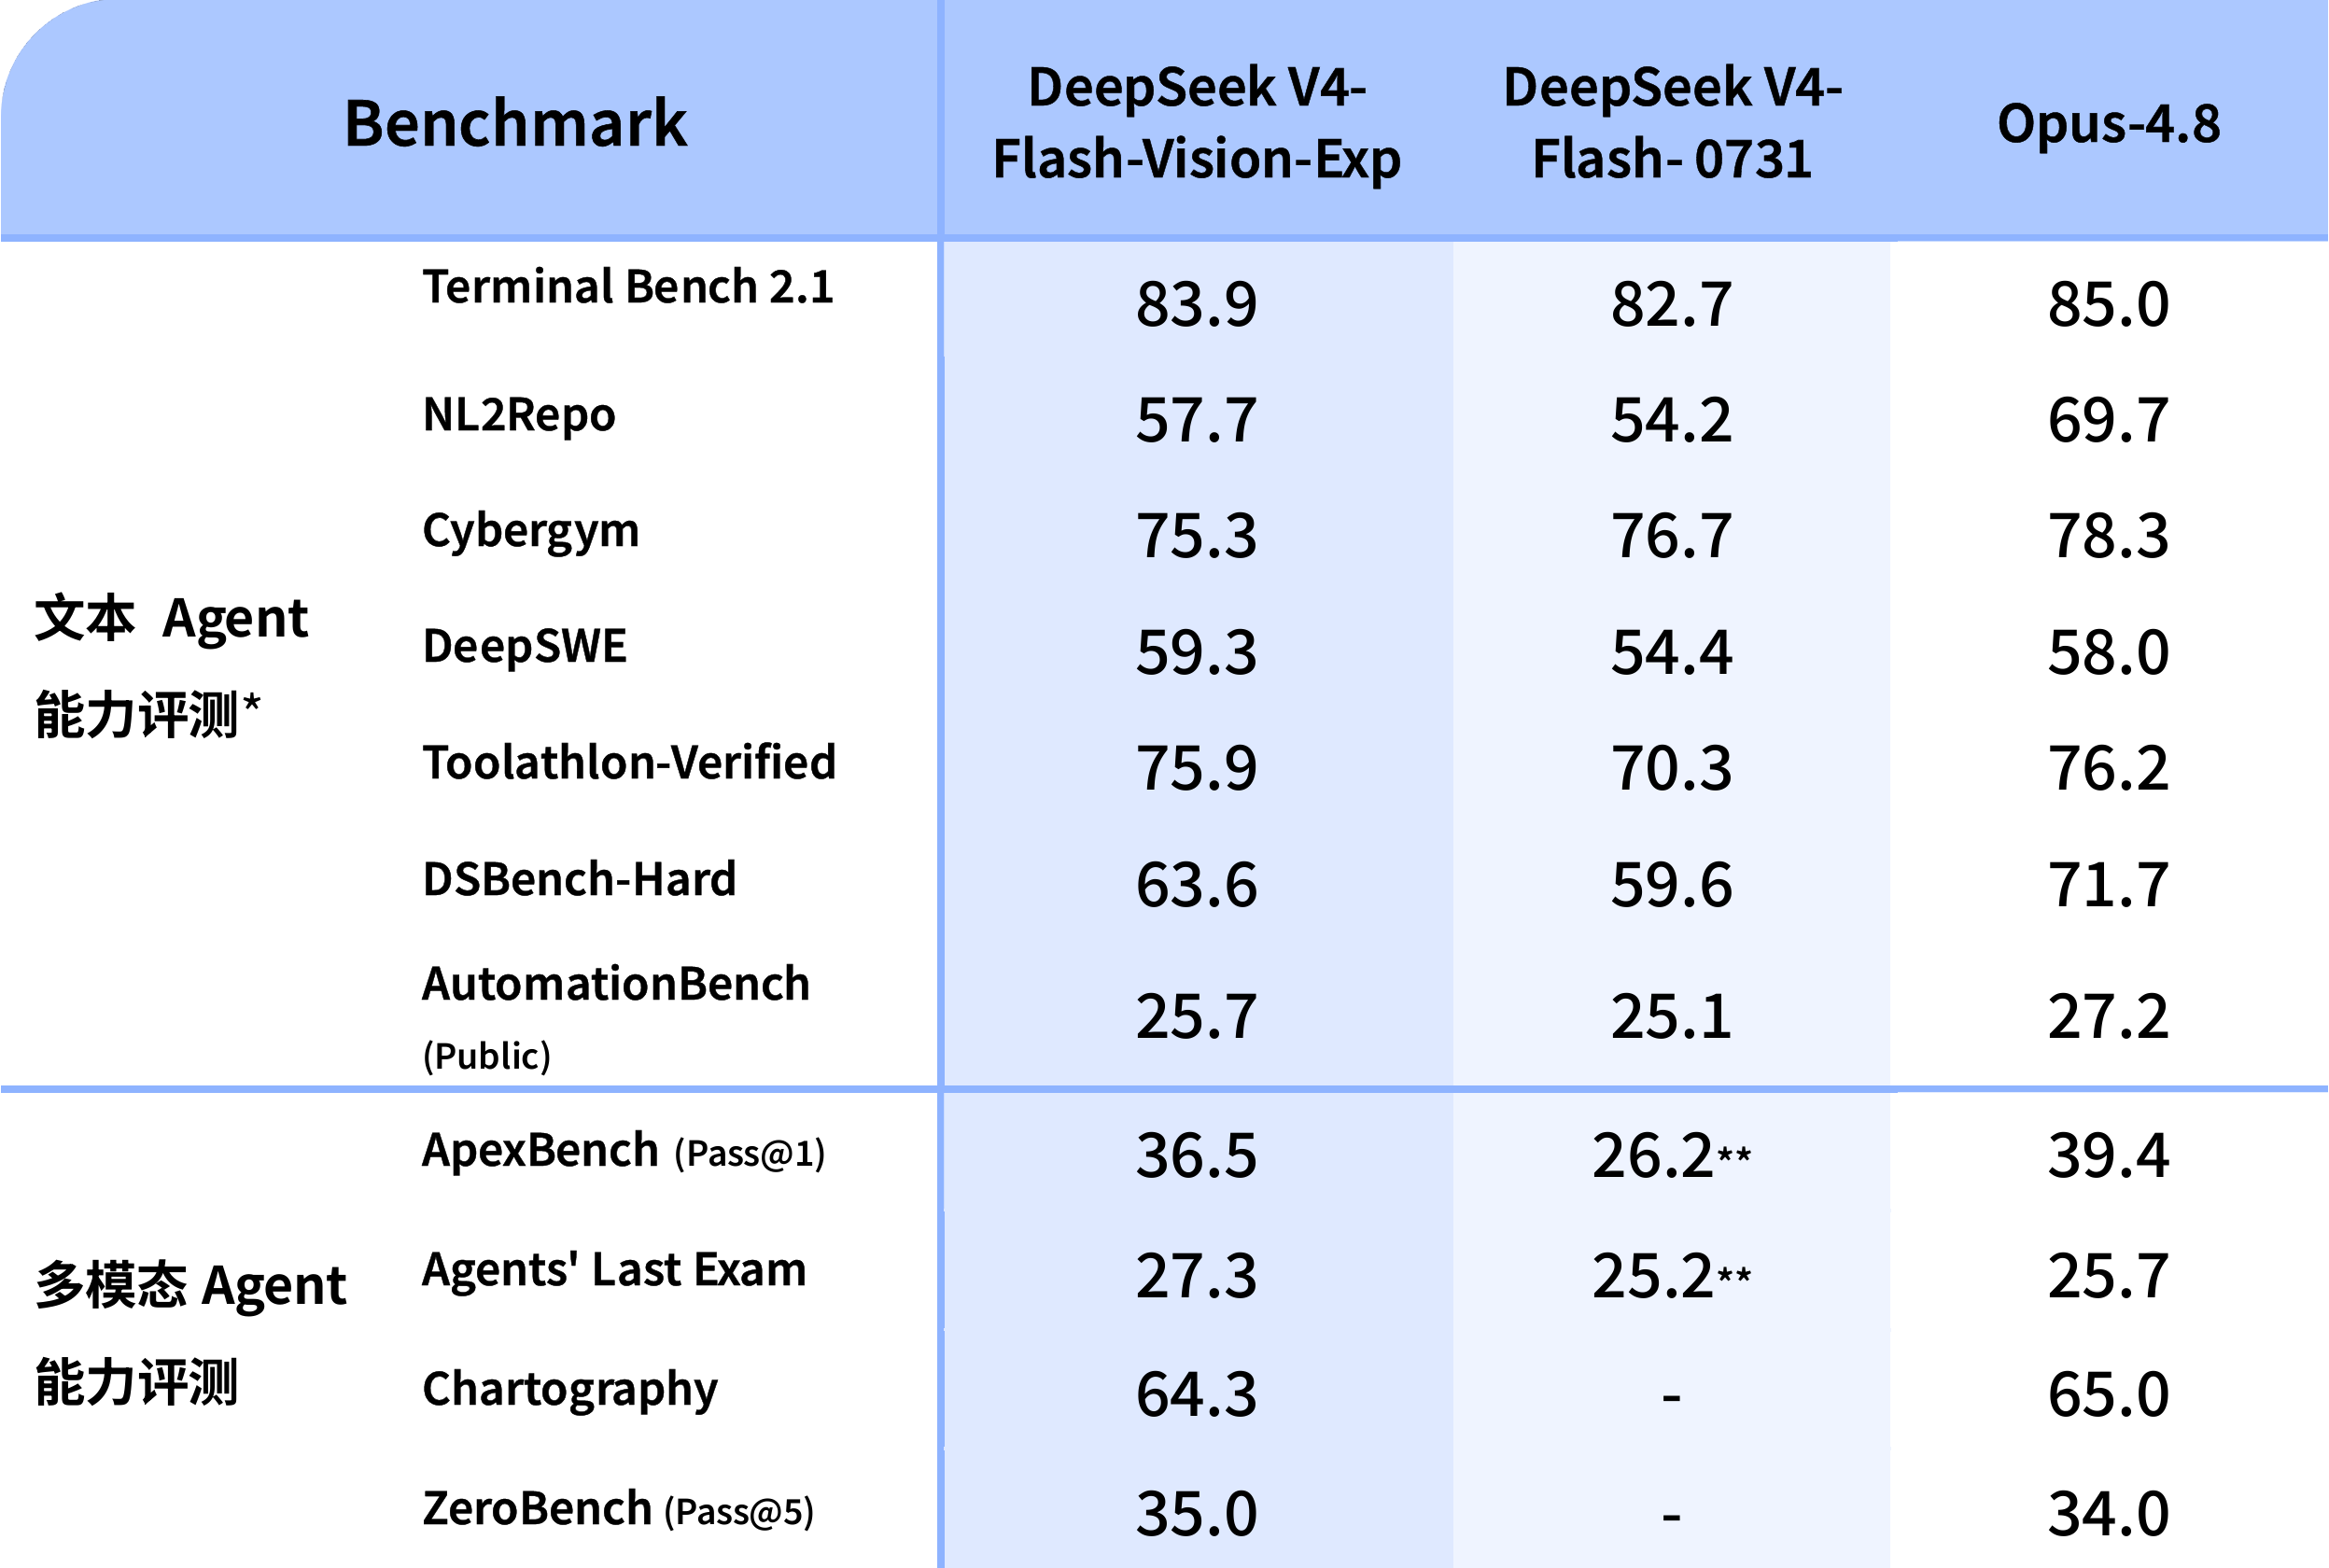
V4-Flash-Vision-Exp 上线,开启多模态 API 服务今天,全新的多模态视觉理解模型 DeepSeek-V4-Flash-Vision-Exp 上线 DeepSeek API 平台,这是一个实验性质的模型,用户可以通过设置 model='deepseek-v4-flash-vision-exp' 访问该模型。

平衡文本与多模态能力
*对于公开基准测试集中的 Code Agent 文本任务,DeepSeek 系列模型使用 DeepSeek Harness 极简模式作为框架进行测试,使用 max 档位,temperature=1.0,topp=0.95;
**在 ApexBench 与 Agents' Last Exam 测评中,文本模型 DeepSeek-V4-Flash 会忽略其中的多模态元素。
  • 在纯文本能力(Agent、推理、世界知识等)方面,DeepSeek-V4-Flash-Vision-Exp 与 DeepSeek-V4-Flash 正式版持平;
  • 在需要视觉理解的 Agent Benchmark 上,DeepSeek-V4-Flash-Vision-Exp 相比 DeepSeek-V4-Flash 实现了大幅跃升,多模态 Agent 能力已接近 Opus-4.8。


0813
DeepSeek harness 公测上线,好评体验中

0812-0813

DeepSeek v4 pro GA 和 Grok 4.6 几乎同时发布,但 harness 并没有一起跟着来


0731
DeepSeek-V4-Flash 正式版 API 已上线公测,Agent 能力大幅增强;V4-Pro 暂未变动。

Responses API 目前仅支持 deepseek-v4-flash 模型,暂不支持 deepseek-v4-pro 模型。我们将于 2026 年 8 月初增加对 deepseek-v4-pro 模型的支持。


----------

最近正式版灰度测试的热度又上来了,特地把从 3 月开始的本帖更新一下标题

-----------
0301 时点的舅舅新闻

总算有个相对不路边的媒体舅舅了,下周的意思就是躲得过初一躲不过十五?反正要在两会开幕之前


本帖子中包含更多资源

您需要 登录 才可以下载或查看,没有账号?立即注册

×

评分

参与人数 1战斗力 +1 收起 理由
偽物 + 1 好耶

查看全部评分

回复

使用道具 举报

     
发表于 2026-3-1 16:48 来自手机 | 显示全部楼层
能“生成”图片和视频的多模态模型


—— 来自 Xiaomi 25060RK16C, Android 16, 鹅球 v3.5.99
回复

使用道具 举报

     
发表于 2026-3-1 16:51 | 显示全部楼层
本帖最后由 Evelynn 于 2026-3-1 16:56 编辑

为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经爆表了。
大公司可以用来做影视剧的特效,用极低的成本做出堪比好莱坞大片的效果;自媒体用来生成各种特效短片,配合tiktok,字节在注意力争夺战已经领先太多了。
甚至可预见的未来,大部分人们可能都不会去看电影、电视剧了,我要是好莱坞公司的老总,晚上都睡不着了。


评分

参与人数 3战斗力 -4 收起 理由
偽物 -1 你知道什么是大语言模型吗
csfantasy -1 你知道什么是大语言模型吗
披头破落户 -2 你知道什么是大语言模型吗

查看全部评分

回复

使用道具 举报

     
发表于 2026-3-1 16:55 来自手机 | 显示全部楼层
楼上是说有了一个闭源的领头羊,接下来全部开源的模型都不用关注了?
回复

使用道具 举报

     
发表于 2026-3-1 16:56 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

毕竟财经媒体,可能ds是对股票市场影响力比较大吧,都知道梁文锋主业是啥,发布时基本不可能不整活

评分

参与人数 1战斗力 +1 收起 理由
偽物 + 1 好耶

查看全部评分

回复

使用道具 举报

发表于 2026-3-1 16:56 来自手机 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

应用环境又不一样。

—— 来自 HUAWEI BRA-AL00, Android 12, 鹅球 v3.5.99
回复

使用道具 举报

     
发表于 2026-3-1 17:00 来自手机 | 显示全部楼层
本帖最后由 Indolencoma 于 2026-3-1 17:01 编辑

这新闻为什么看着就没那么真

我的感觉是,DeepSeek从一开始就不像是一个单纯为了做AI而做AI的公司,从来没感觉出DS对图片生成和视频生成有多强的动力,大概炒股、做量化用不到这些
回复

使用道具 举报

     
发表于 2026-3-1 17:00 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

搞代码不知道,我平时是写文和搞点刘备,DS真是便宜又好用啊,sd2也用了一下,小贵就算了限制实在太多了,我想搞个李元霸大战安格隆,都说我不符合平台规则
国外的那几个限制倒是不多,但是贵是真贵,一个月就要好几百,我DS充50块能用很久

回复

使用道具 举报

     
发表于 2026-3-1 17:05 | 显示全部楼层
deepseek开源,大家都能用
回复

使用道具 举报

     
发表于 2026-3-1 17:06 来自手机 | 显示全部楼层
大部分人关注Seedance,仅仅是因为他们看得懂Seedance的成品

评分

参与人数 6战斗力 +6 收起 理由
偽物 + 1 好耶
ctkghost + 1 思路广
并没有人在乎 + 1 好评加鹅
蜇灵 + 1
库德里尔 + 1 233
羊寢 + 1 没毛病

查看全部评分

回复

使用道具 举报

     
发表于 2026-3-1 17:24 | 显示全部楼层
绕指流光 发表于 2026-3-1 16:42
总算有个相对不路边的媒体舅舅了,下周的意思就是躲得过初一躲不过十五?反正要在两会开幕之前

...

希望有深度研究
回复

使用道具 举报

     
发表于 2026-3-1 17:29 来自手机 | 显示全部楼层
希望是明天

—— 来自 鹅球 v3.3.96
回复

使用道具 举报

     
发表于 2026-3-1 17:30 | 显示全部楼层
每周发一次这种新闻就是操盘方的应对措施?
回复

使用道具 举报

     
发表于 2026-3-1 17:34 | 显示全部楼层
sd只是某种程度上做了点导演和摄像的工作,但是完全谈不上剪辑啊…看片总不能不看情绪吧?不是镜头组接就是电影的…

—— 来自 S1Fun

评分

参与人数 1战斗力 +1 收起 理由
偽物 + 1 好评加鹅

查看全部评分

回复

使用道具 举报

     
发表于 2026-3-1 17:36 来自手机 | 显示全部楼层
ds母公司幻方量化,2025年私募收益率56%,管理700亿赚了400亿,所有财经媒体报这个
回复

使用道具 举报

     
发表于 2026-3-1 17:40 来自手机 | 显示全部楼层
木谷高明 发表于 2026-3-1 17:36
ds母公司幻方量化,2025年私募收益率56%,管理700亿赚了400亿,所有财经媒体报这个 ...

这钱是做空美股赚的吗?

评分

参与人数 1战斗力 +1 收起 理由
偽物 + 1 好耶

查看全部评分

回复

使用道具 举报

     
发表于 2026-3-1 17:44 来自手机 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

能力的基础其实还是看 llm 的科研,而 ds 团队作为国内甚至是国际上搞科研的顶尖团队,关注它不为过的

—— 来自 OnePlus PJD110, Android 16, 鹅球 v3.5.99
回复

使用道具 举报

     
发表于 2026-3-1 17:44 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

因为这几家ai公司只有deepseek是一直发论文的,相当于开源了。而且ds的api定价简直就是免费送,一点也不像是要赚钱的样子
回复

使用道具 举报

     
发表于 2026-3-1 17:48 | 显示全部楼层
"with picture, video and text-generating functions", 这记者写错了吧,DS不可能做生图/视频的,视频/图输入的多模态倒是有可能。
感觉现在很多人对deepseek有过高的期望,deepseek其实应该算是前沿实验室,和微软的亚洲研究院定位挺像的,都是大公司下面的研究机构。新模型能力有提升当然最好,就怕没想象中秒天秒地有的人会开始自贬一转咩鳖。
回复

使用道具 举报

头像被屏蔽
     
发表于 2026-3-1 17:49 | 显示全部楼层
提示: 作者被禁止或删除 内容自动屏蔽
回复

使用道具 举报

     
发表于 2026-3-1 17:53 | 显示全部楼层
Azcarlo 发表于 2026-3-1 17:48
"with picture, video and text-generating functions", 这记者写错了吧,DS不可能做生图/视频的,视频/图 ...

deepseek ocr的论文里提到一嘴
可能可以用于反向生成。
回复

使用道具 举报

     
发表于 2026-3-1 17:53 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

sora2出来三个月后就没太多人玩了,seedance没降智前就是加强版sora2,现在卡版权、卡真人、卡排队、卡审核
回复

使用道具 举报

     
发表于 2026-3-1 18:02 来自手机 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

Agent的商用潜力根本不是AIGC能碰瓷的

—— 来自 HUAWEI SGT-AL50, Android 12, 鹅球 v3.4.97-alpha
回复

使用道具 举报

     
发表于 2026-3-1 18:10 来自手机 | 显示全部楼层
木谷高明 发表于 2026-3-1 17:36
ds母公司幻方量化,2025年私募收益率56%,管理700亿赚了400亿,所有财经媒体报这个 ...

岂不是有能力的人控制股票,和**一样牛x
回复

使用道具 举报

     
发表于 2026-3-1 18:21 | 显示全部楼层
ycjiang1337 发表于 2026-3-1 18:02
Agent的商用潜力根本不是AIGC能碰瓷的

—— 来自 HUAWEI SGT-AL50, Android 12, 鹅球 v3.4.97-alpha ...

不冲突的,字节的Seed2.0就是一个Agent向的模型。
我现在在想,字节是不是已经有一个“seed2.0模型作为agent,先调用其他自己生成剧本,再调用seedream5.0生成人设图、分镜稿,再调用seedance2.0生成短视频,再自己筛选剪辑完成长篇AI视频”的完整方案了。
回复

使用道具 举报

发表于 2026-3-1 18:55 来自手机 | 显示全部楼层
只要你每周猜一次,总能猜中的

—— 来自 鹅球 v3.4.97
回复

使用道具 举报

     
发表于 2026-3-1 19:04 | 显示全部楼层
Humpy 发表于 2026-3-1 17:49
开源的好处就是真的有生产力需求的人可以根据需求自行配置,具有稳定性,甚至可以受DEEPSEEK发的论文中的 ...

确实,近期降智太多+排队严重,我的视频计划干脆卡那了。
回复

使用道具 举报

     
发表于 2026-3-1 19:08 来自手机 | 显示全部楼层
本帖最后由 羊寢 于 2026-3-1 20:14 编辑
脸宽 发表于 2026-3-1 17:29
希望是明天

—— 来自 鹅球 v3.3.96

不是明天就是周四,按去年的发布规矩来说是这样

去类脑看了一眼,应该还是烂炒,不过最近也确实应该要更新了
回复

使用道具 举报

发表于 2026-3-1 19:09 来自手机 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

你知不知道seedance也是个大语言模型

—— 来自 鹅球 v3.4.97
回复

使用道具 举报

     
发表于 2026-3-1 19:11 来自手机 | 显示全部楼层
DeepSeek 的Api便宜稳定,本身能力也很强。接下来都传是1M上下文,毕竟网页端已经上线1M上下文了。再加上多模态的传言属实,国产最强,甚至世界最强啊。。。
国内应该没有1M上下文的。国外似乎也只有Gemini能达到1M,Claude的大上下文似乎也不是给普通人用的。
而且DeepSeek还是开源的,你做个产品敢把自己核心的技术开源吗?
绝对的国产之光。

评分

参与人数 1战斗力 +2 收起 理由
darktide + 2 赞同

查看全部评分

回复

使用道具 举报

     
发表于 2026-3-1 19:18 | 显示全部楼层
D指导某方面真的强
回复

使用道具 举报

     
发表于 2026-3-1 19:35 来自手机 | 显示全部楼层
脸宽 发表于 2026-3-1 17:29
希望是明天

—— 来自 鹅球 v3.3.96

阿妹你看,this is your future!
回复

使用道具 举报

     
发表于 2026-3-1 19:52 | 显示全部楼层
villsian 发表于 2026-3-1 19:11
DeepSeek 的Api便宜稳定,本身能力也很强。接下来都传是1M上下文,毕竟网页端已经上线1M上下文了。再加上多 ...

1兆上下文非常利好ai游戏崇祯模拟器。
回复

使用道具 举报

     
发表于 2026-3-1 20:01 来自手机 | 显示全部楼层
Evelynn 发表于 2026-3-1 16:51
为什么都那么关注deepseek?感觉这些大语言模型在商用潜力上被seedance2完爆,那个太恐怖了,商业价值已经 ...

垄断公司就喜欢你这种用户了

—— 来自 鹅球 v3.3.96-alpha
回复

使用道具 举报

     
发表于 2026-3-1 20:03 来自手机 | 显示全部楼层


啊?

—— 来自 HUAWEI PLA-AL10, Android 12, 鹅球 v3.5.99
回复

使用道具 举报

发表于 2026-3-1 20:28 来自手机 | 显示全部楼层
a4ac7 发表于 2026-3-1 20:03
啊?

—— 来自 HUAWEI PLA-AL10, Android 12, 鹅球 v3.5.99

弱智标题党少看

—— 来自 鹅球 v3.4.97

评分

参与人数 1战斗力 +2 收起 理由
a4ac7 + 2 ok

查看全部评分

回复

使用道具 举报

     
发表于 2026-3-1 20:36 | 显示全部楼层
最近seedance2出问题,AI智障小短片都变少了
回复

使用道具 举报

发表于 2026-3-1 20:37 来自手机 | 显示全部楼层
villsian 发表于 2026-3-1 19:11
DeepSeek 的Api便宜稳定,本身能力也很强。接下来都传是1M上下文,毕竟网页端已经上线1M上下文了。再加上多 ...

qwen3.5是1M上下文
回复

使用道具 举报

     
发表于 2026-3-1 20:45 | 显示全部楼层
DS最大的贡献其实是提升了国内ai整体水平,可以看到最近kimi,minimax,智谱,豆包的水平都突飞猛进了。
回复

使用道具 举报

     
发表于 2026-3-1 20:55 | 显示全部楼层
生图不指望,原生多模态来识别图还是很期待的
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

Archiver|手机版|小黑屋|上海互联网违法和不良信息举报中心|网上有害信息举报专区|962110 反电信诈骗|举报电话 021-62035905|Stage1st ( 沪ICP备13020230号-1|沪公网安备 31010702007642号 )

GMT+8, 2026-9-23 08:21 , Processed in 0.247791 second(s), 7 queries , Gzip On, Redis On.

Powered by Discuz! X3.5 Licensed

© 2001-2026 Discuz! Team.

快速回复 返回顶部 返回列表